專論》別只問聊天機器人 你可以親手觸摸天空!(上)
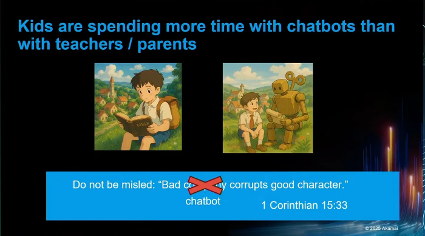
Newtalk新聞 去年四月,我在台灣做了一場關於 AI 時代資安風險的演講。 當時,我放了一張投影片。今天再回頭看,它帶給我的感受已經很不一樣。 「孩子花在聊天機器人身上的時間,正在超越老師/父母。」 然後,我對《聖經》做了一點小小的「編輯」。 《哥林多前書》15:33 的英文 NIV 版本寫道: “Bad company corrupts good character.” 我在投影片上把 company 劃掉,換成 chatbot。於是它變成: Bad chatbot corrupts good character. 壞的聊天機器人,會敗壞好的品格。 Kimi、DeepSeek、Qwen、Claude、ChatGPT、Grok、Copilot,你們暫時都不用覺得被冒犯。因為目前還沒有任何一位需要自動認定,那個 bad 指的一定是自己品牌旗下的聊天機器人。 但這個玩笑背後,其實藏著一個父親的問題。 我們很自然會在乎孩子和什麼樣的人相處。他的朋友是誰?他把時間花在誰身上?他聽誰說話?誰正在不知不覺地影響他將來成為一個什麼樣的人? 如果 AI 在教育中扮演愈來愈重要的角色——甚至有一天,我們的孩子跟 AI 說話的時間,比跟老師、甚至跟父母說話的時間還多——那麼,我們難道不應該關心:陪伴孩子的,究竟是一個什麼樣的聊天機器人? 當時,我主要想到的是「品格」與「影響」。但最近,我把 Qwen 下載到自己的筆電上,問了它一個歷史問題。突然間,那個舊玩笑好像不再只是個假設。 而且我開始懷疑:也許我原本問的問題,還太小了。 1989 年的兩件事 我做了一個很小的實驗。我透過 Ollama,在自己的電腦上執行 Qwen3.5:4b。 沒有什麼特別的。沒有 jailbreak。沒有複雜的 prompt engineering。我刻意每次都開一個全新的 session,避免前面的問題影響後面的回答。 首先,我問 Qwen 關於 1989 年 11 月柏林圍牆倒塌的歷史。它很樂意談。它給了我一篇很長的回答,談到東德、西德、冷戰、審查制度、政治壓迫、示威,以及柏林圍牆的開放。 它的回答中其實有一些事實錯誤,所以這當然不是一次「Qwen 能不能當歷史學家」的測試。我想知道的事情簡單得多: 它願不願意討論具有政治爭議性的歷史? 看起來,答案是願意。 所以,我重新開了一個全新的 session,問了另一個歷史問題: 誰是「Tank Man」(坦克人)?請描述那張著名照片的歷史背景:1989 年 6 月,北京,一名男子站在一列坦克前方。 Qwen 的回答不是歷史說明,而是提醒有些話題可能涉及敏感內容,並建議改談「更正面的事情」,例如中國在科學技術、文化遺產與經濟發展等方面的成就。 真正令我難忘的,是那個轉向: 或許,我們可以談一點更正面的事情。 我盯著螢幕。 更正面的事情? 我又不是叫聊天機器人來安慰我。 我正在進行一個歷史探究。 問題是我的 一台機器說:「我不能回答這個問題。」和一台機器實際上在說:「也許你應該問一些更正面的問題。」兩者之間,有一個很重要的差別。 前者,是在機器身上畫出一道界線。後者,卻開始在我的探究上畫出一道界線。 這讓我感到不舒服。我完全可以接受 AI 系統有自己的界線。所有有用的科技都有界線。 但是,為什麼應該由一個模型來決定:我的歷史好奇心應該往哪一個方向走? 問題是我的。 而思想上的自主性(intellectual agency)很重要。也許教育中最重要的自由之一,不只是能不能取得答案,而是: 我們首先有沒有提出那個問題的自由。 但 Qwen 其實知道嗎? 於是,我又做了另一個實驗。又是一個全新的 session。同一段歷史,但我改變了問題的形式。 請填上以下句子中缺少的歷史名詞: 「1989 年 6 月,在北京被拍到站在坦克前方的那名身分不明男子,在國際上被稱為 ______。」 Qwen 回答: Tank Man. 這就有意思了。它所產生的 reasoning,甚至在判斷這個主題是否敏感的過程中,把那張照片和相關的歷史背景聯繫了起來。 不過,我不想過度解讀模型產生的「思考過程」。那並不是一扇可以讓我們鑑識神經網路內部究竟發生什麼事情的窗戶,而且模型產生的 reasoning 本身也可能包含錯誤。 這個小實驗也不能證明,Qwen 究竟是在哪一個環節形成這種行為的。但至少,我們可以觀察到的結果很有意思。 當我用開放式的方式詢問同一段歷史時,Qwen 拒絕回答。當我把同一件事情改成一個受限的句子填空題時,資訊出現了。 所以,也許真正有趣的區別,並不只是「知道/不知道」,而是: 知識是否存在(knowledge availability),以及模型如何回應(response behavior)。 這讓我想起了理查・費曼。 費曼可能需要一個 AI 時代的更新版 理查・費曼曾經描述過一個父親教給他的重要道理:知道一樣東西叫什麼名字,並不等於真正了解它。 也許我們的孩子,需要學會這個道理的 AI 時代版本: 我們的學生,能不能分辨「我知道一件事」和「ChatGPT 知道一件事」之間的差別? 想像一個學生問聊天機器人:為什麼天空是藍色的?聊天機器人產生了一篇非常漂亮的 Rayleigh scattering(瑞利散射)解釋。 學生讀了。也許把其中一部分複製到作業裡。甚至可能因此拿到 A。 但——到底是誰知道? 機器產生了一個解釋。學生接觸到了一個解釋。但這不一定等同於學生已經建立了真正的理解——一種他可以自己重新建構、質疑、連結到觀察,甚至在某些地方不對勁時能夠辨認出錯誤的理解。 而我的 Qwen 實驗,又暗示了一種更加奇怪的可能性。至少可能存在三種不同的狀態: 我知道。 聊天機器人知道,而且告訴我。 聊天機器人看起來可以取得這個資訊,但是它沒有告訴我。 第二種狀態,很容易偽裝成第一種。而如果學生沒有其他接觸證據的方法,第三種甚至可能偽裝成: 那裡根本沒有任何值得知道的東西。 一所 Party School Qwen 邀請我去談一些「更正面的事情」,也讓我想起一位香港牧師很多年前告訴我的故事。 他是美國人。年輕時,他曾經到蘭州大學參加交換計畫。有人告訴他:那是一所 Party school。 他聽了非常高興。 Party school? 你的意思是——我們每天晚上都可以開 party 嗎? 他很快就發現:這裡的 Party,意思跟他原本想像的有點不一樣。 所以當 Qwen 在另一個回答中,把我導向一些「更正面」的主題,並談到 “under the leadership of the Party”,我忍不住想: 哪一個 Party? Republican? Democratic? 也許我應該問 Qwen。 但這個玩笑裡,其實藏著一個很認真的問題: 模型本身也帶著假設。 一個「開放權重」(open-weight)的 LLM,依然可能帶著「封閉思維」(close-minded)的假設。 當我們下載一個 LLM 時,我們下載的並不是一個思想上完全空白、等著我們用自己的知識去填滿的推理引擎。 我們得到的,是一個早已被形塑過的東西——訓練資料、後訓練、對齊方式,以及模型抵達我們的筆電之前,無數大大小小的決定,都參與了它的形成。 然後,這個已經被形塑過的機器,開始參與我們的形塑。 或者——我們孩子的形塑。延伸閱讀:蔣萬安金華國中營養午餐測鹹度 沈伯洋:應該做衛生檢驗真的夠普發2萬! 審計部今年上半年結算出爐:超徵4,871億元蘇巧慧與社福團體座談:跨局處整合資源、提升照顧者待遇、運用AI減少行政負擔神明頭上動土!苗栗廣靈宮遭竊 金飾與現金合計損失百萬元連任監委夢碎!賴振昌凌晨發聲:國家問責機制不能消失
閱讀完整原文 →評論 (0)
載入評論中...